
این هوش مصنوعی، خطوط باستانی را می خواند
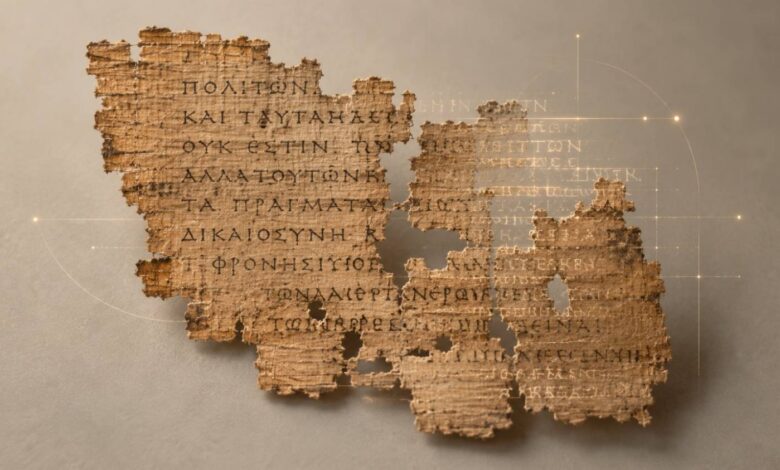
هوش مصنوعی امروزه در حوزههای گوناگونی از جمله پزشکی، حملونقل، آموزش، صنعت و پژوهشهای علمی کاربردهای گستردهای یافته است و با تحلیل حجم عظیمی از دادهها، فرآیندهای پیچیده را تسریع و دقیقتر میسازد. در همین راستا، مدل جدیدی از هوش مصنوعی با نام آپولو توانسته است توانایی مطالعه و بازخوانی بخشهای آسیبدیده کتیبهها و نوشتههای باستانی را فراهم آورد و با پیشنهاد خوانشهای محتمل برای متون ناقص یونانی باستان، افق تازهای را پیش روی پژوهشگران تاریخ و زبانشناسی بگشاید.
به گزارش سیناپرس، موزهها و کتابخانههای سراسر جهان صدها هزار کتیبه باستانی و بیش از یک میلیون قطعه پاپیروس در اختیار دارند، اما پژوهشگران تاکنون تنها حدود هشت درصد از این پاپیروسها را بهطور کامل رمزگشایی کردهاند. خواندن متون آسیبدیده یونانی باستان نیازمند تخصص نادر و صرف زمان بسیار زیاد است و دقیقاً در همین نقطه است که آپولو (Apollo)، مدل جدید هوش مصنوعی که بهطور ویژه برای این زبان طراحی شده، میتواند یاریرسان باشد.
این مدل هوش مصنوعی ماحصل همکاری متخصصان فرهنگستان علوم اتریش، شرکت هوش مصنوعی میسترال (Mistral)، سیل ریپلای (SAIL Reply) و دانشگاه نورثایسترن (Northeastern University) محسوب شده و تیم سازنده آن را نخستین مدل زبانی بزرگ جهان میداند که ویژه زبان یونانی باستان ساخته شده است. وظیفه اصلی آپولو پر کردن جاهای خالی در اسناد باستانی است؛ جایی که خطوط شکسته، واژههای مفقود و بخشهای آسیبدیده اند. این مدل میتواند در عرض چند ثانیه خوانشهای ممکن را پیشنهاد دهد.
لازم به ذکر است که آپولو با حدود ششصد میلیون واژه از متون یونانی باستان آموزش دیده است. این حجم بسیار کمتر از دهها میلیارد واژهای است که معمولاً برای آموزش مدلهای زبانی مدرن به کار میرود. پژوهشگران عملکرد مدل را بر روی پاپیروسهای واقعی آزمایش کردند؛ به این صورت که بخشهایی از متونی را که پیشتر توسط متخصصان بازسازی شده بود پنهان کردند. آپولو در حدود هشتاد درصد موارد، خوانش صحیح را در میان پیشنهادهای برتر خود قرار داد.
در یک ارزیابی کور، بیست متخصص در حوزههای پاپیروسشناسی (علم مطالعه متون نوشتهشده بر پاپیروس)، کتیبهشناسی و زبانشناسی تاریخی، پیشنهادهای آپولو را با خوانشهای منتشرشده علمی مقایسه کردند. برای پاپیروسهای اسنادی، پژوهشگران برآورد کردند که خوانش آپولو در حدود هفتاد و هفت درصد موارد دستکم به اندازه نسخه منتشرشده خوب بوده است. هنگامی که خوانش آپولو با نسخه منتشرشده اختلاف داشت، متخصصان در شانزده درصد موارد مربوط به پاپیروسهای اسنادی و حدود بیست درصد موارد مربوط به کتیبهها، پیشنهاد آپولو را ترجیح دادند.
گفتنی است آپولو تاکنون بر روی چند متن باستانی واقعی آزمایش شده و در نمایشهای عمومی، این مدل یک گواهی تولد باستانی را تکمیل، بخشهای مهمی از یک طومار پاپیروسی آسیبدیده در اثر فوران کوه وزوو (Vesuvius) را بازیابی نمود و به پژوهشگران کمک کرد نشانههایی از حقوق رومی از جمله از طریق اشاره به یک مالیات رومی را در شهری در کنار دریای سیاه ردیابی کنند.
این مدل همچنین قادر است دورههای زمانی و سبکهای نوشتاری مختلف را تشخیص دهد. به گفته دولگانوف، آپولو میتواند تشخیص دهد که یک قطعه با ساختار و واژگان آثاری مانند ادیسه هومر همخوانی دارد و سپس متن مفقود را به سبکی مشابه پیشنهاد کند.
در پایان لازم به ذکر است که آپولو میتواند مطالعه متون باستانی را با ارائه خوانشهای ممکن برای بخشهای آسیبدیده در عرض چند ثانیه تسریع بخشد. این امر میتواند هزاران پاپیروس خواندهنشده را در دسترس پژوهش دقیقتر قرار دهد و جزئیات تازهای درباره زندگی، حقوق، ادبیات و تاریخ باستان آشکار سازد.
مترجم: احسان محمدحسینی