
رباتها چگونه راه رفتن را یاد میگیرند؟
وقتی یک انسان راه میرود، معمولاً به این فکر نمیکند که ابتدا پای راست را چند سانتیمتر جلو ببرد، وزن بدن را چگونه منتقل کند و سپس پای چپ را دقیقاً در چه نقطهای قرار دهد. مغز و دستگاه عصبی این کار را تقریباً بهصورت خودکار انجام میدهند. اما موضوع برای یک روبات چگونه است؟ آیا مهندسان برای تکتک قدمهای آن دستور نوشتهاند؟
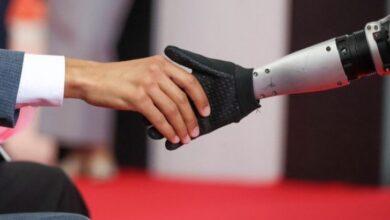
به گزارش سیناپرس، ربات ها در سال های اخیر نقش مهمی در فناوری های انسانی ایفا کرده و هر روز شاهد تکامل و پیشرفت روبات های انسان نمایی هستیم که رفتارهای انسان را دقیقا تقلید کرده و مشابه انسان راه می روند.
حال این پرسش مطرح می شود که آیا نوع راه رفتن روبات ها دارای الگوریتمی مشابه راه رفتن انسان ها است یا خیر؟ در پاسخ باید گفت که اگرچه برخی روباتها همچنان با الگوریتمهای از پیش طراحیشده کنترل میشوند اما نسل جدید روباتهای چهارپا و انساننما از روشهایی مانند یادگیری تقویتی، یادگیری تقلیدی و شبیهسازی فیزیکی استفاده میکنند تا خودشان الگوهای مناسب حرکت را پیدا کنند. پژوهشهای جدید نشان میدهد که یادگیری حرکتی در روباتها به یکی از مهمترین شاخههای هوش مصنوعی و روباتیک تبدیل شده است.
در نگاه نخست، راه رفتن کاری به ظاهر ساده است، اما از دید مهندسی یکی از مسائل بسیار دشوار کنترل حرکت محسوب میشود و به همین دلیل بدن روبات هنگام راه رفتن دائماً در حال تغییر وضعیت است. مرکز جرم آن جابهجا میشود، پاها از زمین جدا و دوباره با آن تماس پیدا میکنند و نیروهای مختلفی از زمین به بدن وارد میشود. این شرایط برای طراحان روبات ها یک چالش بسیار جدی است زیرا روبات باید در هر لحظه بداند که بدنش چه زاویهای دارد؛ با چه سرعتی حرکت میکند؛ مفاصلش در چه وضعیتی هستند؛ پاها در کجا قرار گرفتهاند؛
آیا پایش با زمین تماس دارد یا نه و برای حفظ تعادل، موتورهای مفاصل را با چه نیرویی حرکت دهد.برای این کار از مجموعهای از حسگرها، از جمله واحد اندازهگیری اینرسی ، حسگرهای موقعیت مفصل، حسگرهای نیرو و گاهی دوربین و سامانههای بینایی استفاده میشود.
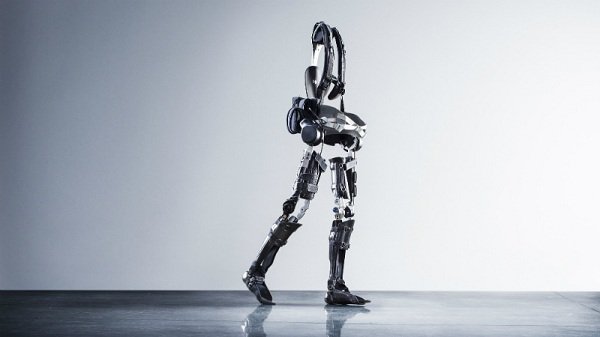
بنابراین روبات فقط حرکت نمیکند؛ بلکه دائماً وضعیت خود را اندازه و حرکت بعدی را اصلاح میکند. در این میان یکی از روشهای مهم، یادگیری تقویتی است. در این روش، یک عامل هوشمند بارها تلاش میکند کاری را انجام دهد و بر اساس نتیجه، رفتار خود را تغییر میدهد. اگر حرکت به هدف نزدیکتر شود، امتیاز دریافت میکند و اگر روبات زمین بخورد یا حرکت نامناسبی انجام دهد، امتیاز کمتری میگیرد.
در مورد راه رفتن، هدف میتواند ترکیبی از چند معیار باشد: حرکت در جهت مورد نظر، حفظ تعادل، مصرف انرژی کمتر، جلوگیری از لغزش و حرکت نرمتر. بهاینترتیب روبات بهتدریج درمییابد که چه ترکیبی از حرکات مفاصل احتمال موفقیت بیشتری دارد. نکته مهم این است که این فرآیند الزاماً در دنیای واقعی انجام نمیشود زیرا فرستادن یک روبات چندصد کیلوگرمی به محیط واقعی برای اینکه میلیونها بار زمین بخورد، هم بسیار پرهزینه است و هم ممکن است به تجهیزات آسیب بزند.
به همین دلیل، پژوهشگران ابتدا یک نسخه مجازی از روبات میسازند و آن را در یک شبیهساز فیزیکی قرار میدهند. در این محیط مجازی، روبات میتواند میلیونها بار تلاش کرده، زمین بخورد، بلند شود و دوباره راه رفتن را امتحان کند؛ بدون اینکه موتور یا مفصل واقعی آن آسیب ببیند.
جالب است که سامانههایی مانند NVIDIA Isaac Lab برای همین نوع یادگیری روباتها طراحی شدهاند و امکان آموزش سیاستهای حرکتی در مقیاس بسیار بزرگ را فراهم میکنند. به این ترتیب، چیزی که ممکن است برای یک روبات واقعی ماهها یا سالها تجربه ایجاد کند، میتواند در محیط شبیهسازی بسیار سریعتر انجام شود.
در این میان اما یک مشکل بزرگ وجود دارد: دنیای واقعی با شبیهسازی فرق داشته و ممکن است روبات در کامپیوتر بهخوبی راه برود، اما وقتی همان برنامه را روی روبات واقعی اجرا کنیم، ناگهان تعادلش را از دست بدهد.
چون شبیهساز هرگز کاملاً شبیه جهان واقعی نیست و وزن دقیق قطعات، اصطکاک کف زمین، انعطافپذیری اجزای مکانیکی، تأخیر موتور، خطای حسگرها، لرزشها و حتی نحوه برخورد پا با زمین ممکن است با مدل کامپیوتری تفاوت داشته باشد. به همین دلیل یکی از راهکارهای جالب پژوهشگران این است که محیط شبیهسازی را بیش از حد ایدهآل طراحی نکنند.
آنها در زمان آموزش، عمداً پارامترهای مختلف را تغییر میدهند: وزن روبات کمی تغییر میکند، اصطکاک زمین متفاوت میشود، سرعت موتورها تغییر میکند یا به روبات ضربههای تصادفی وارد میشود. به این ترتیب، روبات به یک شرایط خاص وابسته نمیشود، بلکه یاد میگیرد در طیف وسیعی از شرایط تعادل خود را حفظ کند زیرا راه رفتن روی یک کف صاف نسبتاً قابل پیشبینی است. اما وقتی زمین سنگلاخ، لغزنده، شیبدار یا دارای پله و مانع باشد، مسئله کاملاً متفاوت میشود و روبات باید همزمان محیط را تشخیص دهد و حرکت خود را با آن تطبیق دهد. برای همین، روباتهای پیشرفتهتر به ترکیبی از بینایی ماشین، حسگرهای بدنی و الگوریتمهای کنترل حرکتی متکی هستند.
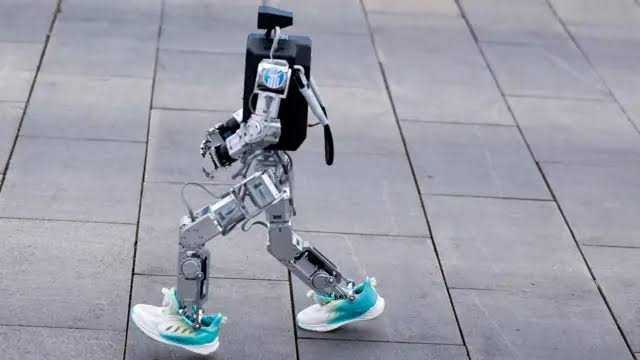
در این میان باید توجه داشت که روبات، مفهوم راه رفتن را مانند انسان درک نمیکند. آنچه یاد میگیرد، یک الگوی ریاضی و کنترلی بسیار پیچیده است که به وی اجازه میدهد از وضعیتهای مختلف به حرکت مطلوب برسد.
به همین دلیل ممکن است یک روبات بدون اینکه هیچ دستور مستقیمی درباره تکتک حرکات پا دریافت کرده باشد، در طول آموزش به یک الگوی راه رفتن برسد که از نظر ظاهری شبیه راه رفتن انسان یا حیوان باشد. حتی جالبتر اینکه گاهی بهترین راه رفتن برای روبات، دقیقاً شبیه راه رفتن انسان نیست. طراحی مکانیکی، تعداد مفاصل، وزن بدن و نوع موتورهای آن تعیین میکنند که چه نوع حرکتی از نظر انرژی و پایداری مناسبتر است.
در نهایت باید توجه داشت که راه رفتن برای یک روبات بسیار پیچیدهتر از آن چیزی است که از بیرون به نظر میرسد. روبات باید دائماً وضعیت بدن خود را اندازهگیری کند، تعادل را حفظ کند، نیروهای واردشده را پیشبینی کند و حرکت مفاصل را در کسری از ثانیه اصلاح کند. بنابراین وقتی روبات انساننمایی را میبینیم که راه میرود، از پله بالا میرود یا پس از هل داده شدن دوباره تعادلش را پیدا میکند، پشت این حرکت ساده، میلیونها تجربه مجازی، دادههای حسگر، محاسبات کنترلی و الگوریتمهای یادگیری قرار دارد.
گزارش: احسان محمدحسینی