

گاهی تلفن همراه فقط با یک نگاه به صورت ما قفلش را باز میکند؛ دوربین فرودگاه میتواند چهرهای را میان میلیونها تصویر جستوجو کند و شبکههای اجتماعی حتی میتوانند افراد یک عکس را پیشنهاد دهند. اما پشت این «نگاه» چه اتفاقی میافتد؟ آیا رایانه واقعاً چهره ما را میشناسد یا فقط شباهتهای عددی میان تصاویر را محاسبه میکند؟
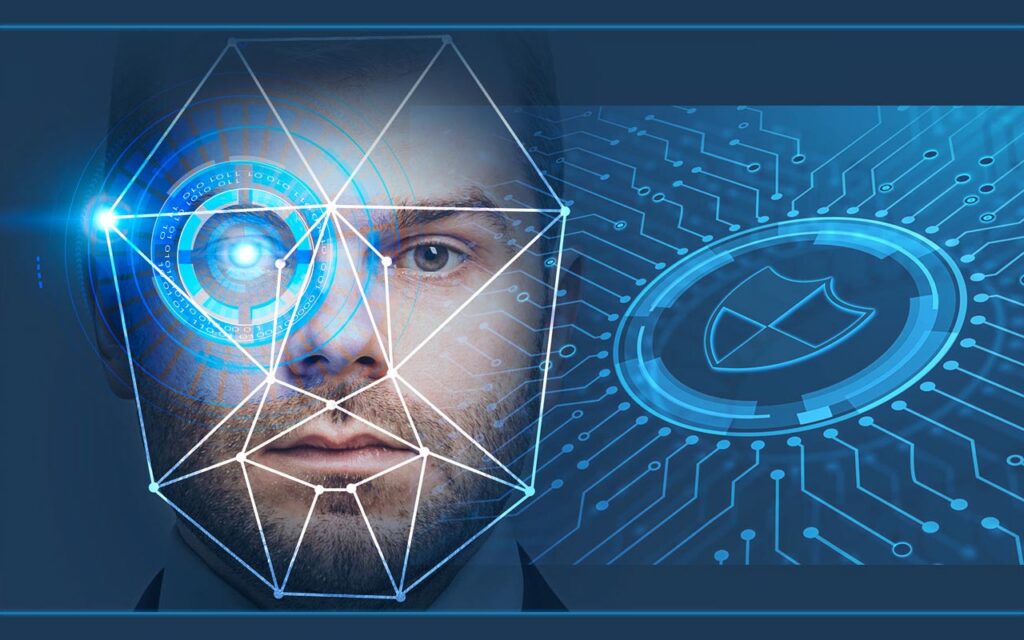
به گزارش سیناپرس، تشخیص چهره در واقع نوعی زیستسنجی است؛ یعنی استفاده از یک ویژگی نسبتاً منحصربهفرد بدن انسان برای تشخیص یا تأیید هویت. اما برخلاف تصور رایج، رایانه معمولاً چهره را مانند انسان نمیبیند. سامانه تصویر را به مجموعهای بسیار بزرگ از اعداد تبدیل میکند و سپس با استفاده از الگوهای ریاضی بررسی میکند که این اعداد تا چه اندازه با الگوی مربوط به یک فرد دیگر شباهت دارند.
فرآیند معمول را میتوان در چند مرحله تصور کرد. نخست، دوربین یا تصویر دیجیتال وارد سامانه میشود. نرمافزار باید چهره را در تصویر پیدا کند؛ کاری که به آن تشخیص چهره یا Face Detection گفته میشود. در یک عکس خانوادگی، برای مثال، سیستم ابتدا باید مشخص کند کدام بخشهای تصویر مربوط به چهره انسان است.
در مرحله بعد، تصویر برای مقایسه آماده میشود. زاویه صورت، اندازه، موقعیت چشمها و شرایط تصویربرداری میتواند متفاوت باشد؛ بنابراین سامانه معمولاً تصویر را همتراز و تا حدی استاندارد میکند. سپس نوبت بخش اصلی کار میرسد: استخراج ویژگیها.
در سامانههای قدیمیتر، پژوهشگران تلاش میکردند ویژگیهایی مانند فاصله چشمها، شکل بینی یا ساختار کلی صورت را بهصورت مشخص تعریف کنند. اما سامانههای امروزی عمدتاً از یادگیری عمیق و بهویژه شبکههای عصبی کانولوشنی استفاده میکنند. این شبکهها با دیدن تعداد بسیار زیادی تصویر، بهتدریج یاد میگیرند کدام الگوهای تصویری برای تشخیص هویت مفیدتر هستند.
نتیجه این مرحله معمولاً یک تصویر قابلخواندن برای انسان نیست، بلکه یک بردار عددی یا اصطلاحاً «تعبیه چهره» است. به زبان ساده، میتوان تصور کرد که سامانه برای هر چهره یک مختصات بسیار پیچیده در یک فضای ریاضی ایجاد میکند. دو تصویر از یک فرد باید در این فضا به یکدیگر نزدیکتر باشند و تصاویر دو فرد متفاوت معمولاً فاصله بیشتری داشته باشند. پژوهش NIST و همکاران در سال ۲۰۱۸ نیز دقیقاً نشان داد که شبکههای عصبی عمیق، چهرهها را به بردارهای فشردهای از ویژگیها تبدیل و سپس میزان شباهت این نمایشها را محاسبه میکنند.
اما «تشخیص چهره» دو کاربرد متفاوت دارد که نباید با یکدیگر اشتباه شوند. در تأیید هویت یکبهیک، سامانه میپرسد: «آیا این چهره همان شخصی است که ادعا میکند؟» برای مثال هنگام باز کردن قفل تلفن. در شناسایی یکبهچند، پرسش متفاوت است: «این چهره متعلق به کدام فرد در میان مجموعه بزرگی از افراد است؟» کاربردهای امنیتی و جستوجوی پایگاههای تصویری معمولاً به نوع دوم نزدیکاند. NIST نیز این دو نوع ارزیابی را بهطور جداگانه بررسی میکند.
در مرحله نهایی، سامانه یک امتیاز شباهت تولید میکند. اگر این امتیاز از یک آستانه مشخص بالاتر باشد، سیستم میتواند اعلام کند که دو تصویر احتمالاً متعلق به یک فرد هستند. این نکته مهم است: سامانه لزوماً نمیگوید «این شخص قطعاً علی است»؛ بلکه بر اساس داده و آستانه تصمیم، میزان شباهت را ارزیابی میکند. تغییر آستانه میتواند تعداد خطاهای مثبت کاذب و منفی کاذب را تغییر دهد. پژوهشهای مقایسهای نیز نشان دادهاند که انتخاب آستانه و کیفیت تصاویر میتواند بر عملکرد و حتی تفاوت عملکرد میان گروههای جمعیتی اثر بگذارد.
پس چرا سامانهای که در شرایط مناسب بسیار دقیق است، گاهی اشتباه میکند؟ پاسخ ساده است: چهره انسان ثابت نیست. نور، زاویه دوربین، فاصله، کیفیت تصویر، حالت چهره، افزایش سن، پوشش صورت و حتی کیفیت دوربین میتوانند مسئله را دشوار کنند. علاوه بر این، کیفیت و تنوع تصاویر آموزشی اهمیت زیادی دارد. یک مرور نظاممند در سال ۲۰۲۵ نیز تأکید کرد که بسیاری از مجموعهدادهها از نظر تنوع جمعیتشناختی و شرایط واقعی محدودیت دارند و این مسئله میتواند قابلیت تعمیم سامانه را کاهش دهد.
موضوع دیگری که در سالهای اخیر توجه زیادی به خود جلب کرده، تفاوت عملکرد میان گروههای جمعیتی است. مطالعه NIST در سال ۲۰۱۹ روی ۱۸/۲۷ میلیون تصویر از ۸/۴۹ میلیون نفر نشان داد که در بسیاری از الگوریتمهای بررسیشده، عملکرد میان گروههای مختلف جمعیتی یکسان نیست؛ با این حال، میزان تفاوت به الگوریتم و کاربرد بستگی داشت و نمیتوان یک حکم کلی درباره همه سامانهها صادر کرد.
نکته جالب این است که انسان نیز همیشه تشخیصدهنده بیخطایی نیست. در یک مطالعه مشترک NIST، دانشگاه تگزاس در دالاس، دانشگاه مریلند و دانشگاه نیو ساوت ولز در سال ۲۰۱۸، چهار شبکه عصبی عمیق با گروههای انسانی متخصص و غیرمتخصص مقایسه شدند. بهترین الگوریتم در آزمون به AUC برابر ۹۶ درصد رسید؛ میانه کارشناسان شناسایی چهره ۹۳ درصد بود. مهمتر اینکه ترکیب قضاوت انسان و الگوریتم، از عملکرد بسیاری از حالتهای فردی بهتر بود.
در مجموع، سامانه تشخیص چهره را نباید یک «ماشین نگاهکننده» تصور کرد. این فناوری در اصل زنجیرهای از تشخیص چهره، آمادهسازی تصویر، استخراج ویژگی، تبدیل ویژگیها به نمایش عددی، مقایسه ریاضی و تصمیمگیری بر اساس آستانه است. پیشرفت یادگیری عمیق باعث شده این فرایند بسیار قدرتمندتر شود، اما دقت آن همچنان به کیفیت الگوریتم، دادههای آموزشی، شرایط تصویربرداری، جمعیت مورد بررسی و نحوه استفاده از نتیجه وابسته است. به همین دلیل، عددی مانند «دقت ۹۹ درصد» بدون دانستن اینکه سامانه روی چه تصاویری، چه افرادی و برای چه کاری آزمایش شده است، بهتنهایی معنای علمی کاملی ندارد.
گزارش: میتراسادات میرفیضی